2026年9月15日、CloudflareがAIクローラーの既定値を変更します。広告を掲載しているページでは、学習用(Training)とエージェント用(Agent)のクローラーが既定でブロックされます。
対象は限定的です。新規にCloudflareへ接続するドメイン、既存アカウントに新しく追加されるサイト、そして無料プランのサイト。既存の本番ドメインが9月15日に自動で切り替わるわけではありません。
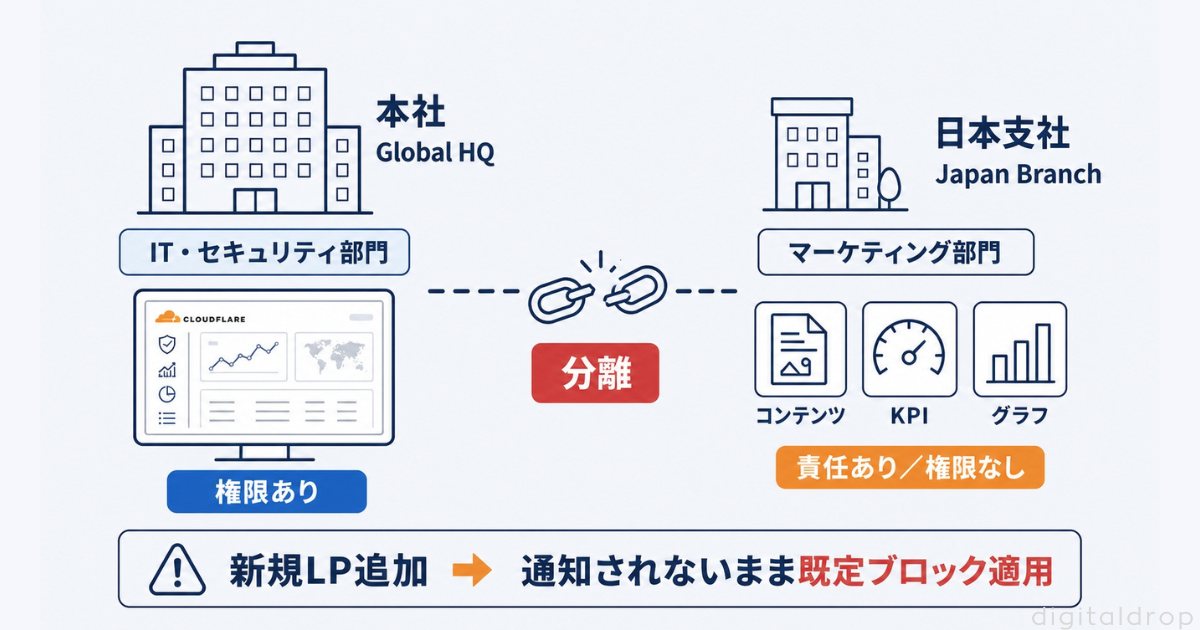
ただし外資系企業の日本支社には固有のリスクがあります。日本支社がこれから立ち上げるキャンペーンLPや新サービスサイトは「既存アカウントに新しく追加されるサイト」に該当するためです。そしてCloudflareの管理画面は、多くの場合、本社のIT部門が握っています。
もう1点。「AI学習をブロックすると生成AIに引用されなくなる」という説明は誤りです。引用の生命線は学習用クローラーではなく、エージェント用クローラーにあります。
記事のポイント:
- 2026年9月15日から、広告掲載ページではTrainingとAgentのクローラーが既定でブロックされる。Searchは既定で許可のまま(Cloudflare 2026年7月1日発表)
- 対象は「新規ドメイン」「既存アカウントへの新規追加サイト」「無料プラン」の3種類。既存の本番ドメインは自動変更されない
- ChatGPTやPerplexityが回答時に参照するのはAgentクローラー。ai-trainだけを拒否しても引用は消えず、逆にAgentを塞ぐと引用は消える
- AI経由の流入は量こそ小さいが、2026年3月時点で非AI経由より42%高いコンバージョン率を記録している(Adobe Analytics 2026年4月16日発表)
目次
2026年9月15日、Cloudflareで何が変わるのか
結論から述べると、変わるのは「AIクローラーをどう分類するか」と「広告掲載ページでの既定値」の2点です。
Cloudflareは2026年7月1日、AIトラフィックの新しい管理オプションを全顧客に提供すると発表し、同時に2026年9月15日から新しい既定値を適用することも公表しました。
出典:Cloudflare公式ブログ「Your site, your rules: new AI traffic options for all customers」(2026年7月1日)
変更の中身は「クローラーの3分類」と「広告掲載ページの既定ブロック」
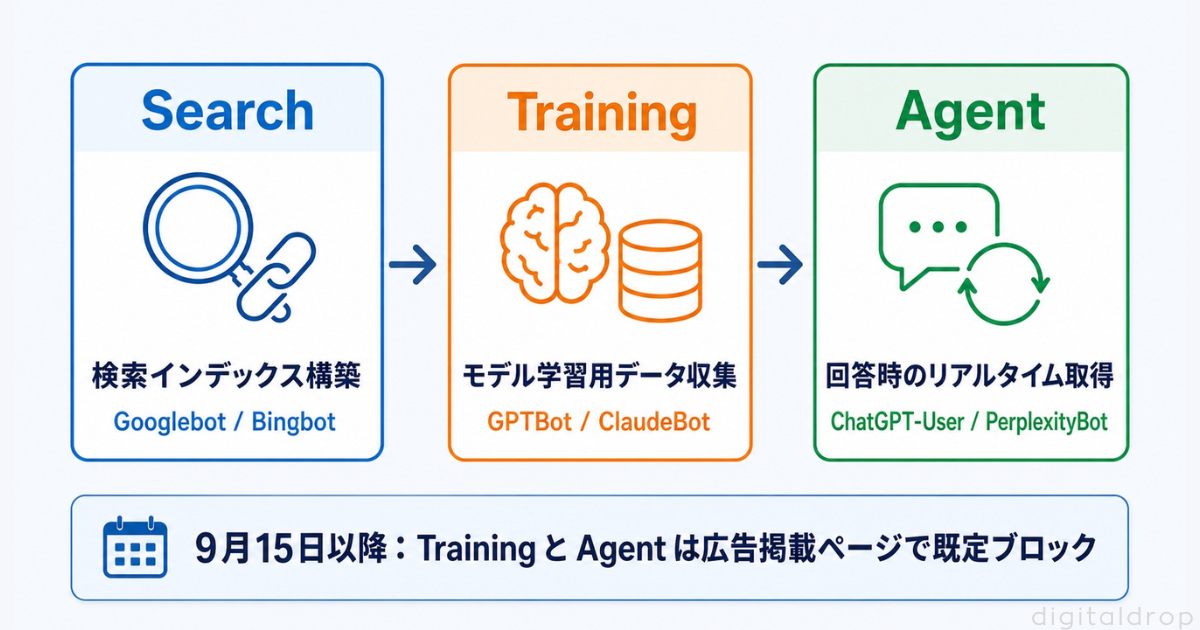
これまでのボット管理は、AIクローラーを一括で「許可」か「ブロック」かで扱うのが基本でした。今回の変更では、クローラーを目的別に3つに分けます。
| 分類 | 目的 | 代表的なクローラー |
| Search | 検索インデックスの構築。リンクと短い抜粋を伴い、ユーザーをサイトへ送る | Googlebot、Bingbot |
| Training | AIモデルの学習・ファインチューニング用のデータ収集 | GPTBot、ClaudeBot |
| Agent | ユーザーの依頼に応じたリアルタイムの取得。生成AIの回答生成に使われる | ChatGPT-User、PerplexityBot |
そして各分類に対して、サイト運営者は3つの設定から選べます。
- 全ページでブロックする
- 広告を掲載しているページでブロックする
- 許可する
2026年9月15日以降、対象となるサイトの既定値は「Searchは許可、TrainingとAgentは広告掲載ページでブロック」に切り替わります。
対象は新規ドメイン・新規追加サイト・無料プラン——全社一括ではない
ここを誤読すると、対応の優先順位を間違えます。既定変更が適用されるのは、次の3つです。
- 1. 新しくCloudflareへ接続するドメイン
- 2. 既存アカウントに新しく追加されるサイト
- 3. 無料プランのサイト
つまり、すでにCloudflareで運用している有料プランの本番ドメインは、9月15日に自動で設定が書き換わるわけではありません。「明日から自社サイトがAIから消える」といった理解は正確ではありません。
一方で、9月15日より前であれば、セキュリティ設定から既定変更のオプトアウトが可能です。Cloudflareは対象顧客への通知を継続すると表明しています。
見落としやすい適用条件 「既存アカウントに新しく追加されるサイト」が含まれる点が実務上もっとも重要です。9月15日以降に新しいドメインやサブドメインをCloudflareへ追加すれば、たとえ本社が長年の有料契約顧客であっても、そのサイトには新しい既定値が適用されます。マーケティング部門が単独で立ち上げるキャンペーンサイトは、この条件にそのまま該当します。
変更前後の既定値を一覧で比較する
| 項目 | 9月15日より前 | 9月15日以降(対象サイト) |
| Searchクローラー | 許可 | 許可(変更なし) |
| Trainingクローラー | 運営者が明示的に設定 | 広告掲載ページでブロック |
| Agentクローラー | 運営者が明示的に設定 | 広告掲載ページでブロック |
| 対象 | — | 新規ドメイン/新規追加サイト/無料プラン |
| オプトアウト | — | 9月15日前にセキュリティ設定から可能 |
「AI学習をブロック=AIに引用されなくなる」は誤りである
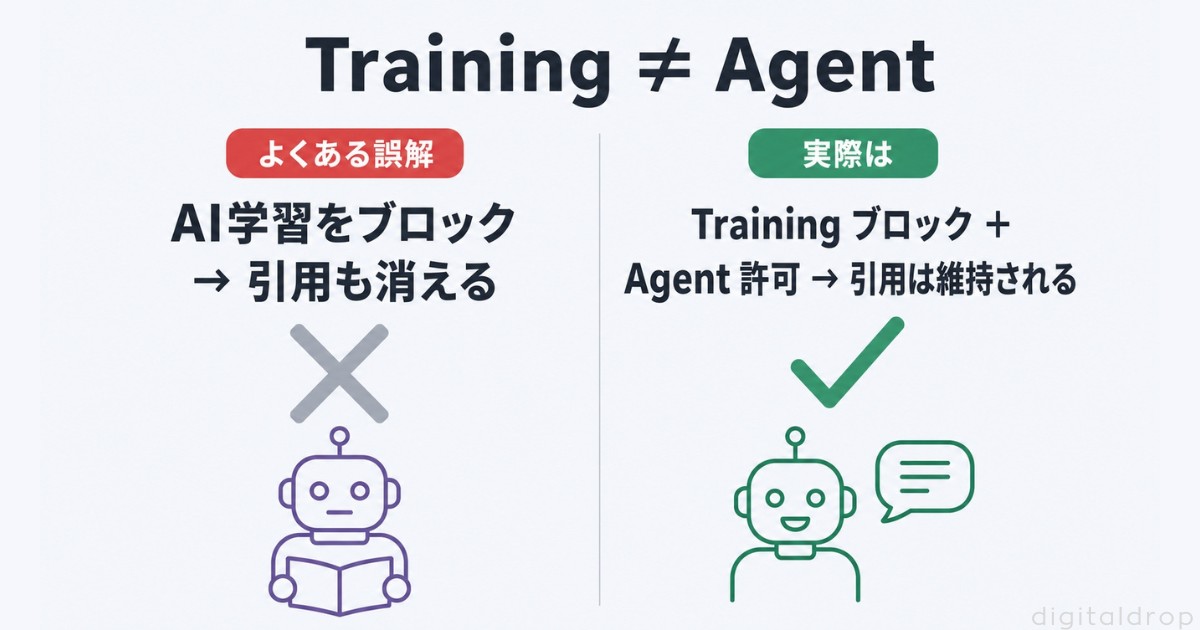
この論点を正確に押さえているかどうかで、対応の質が決まります。結論は明快です。生成AIの回答に引用されるかどうかを決めるのは、TrainingではなくAgentです。
日本語で公開されている解説記事の多くは「AI学習をブロックすると生成AIに引用されなくなる」と要約しています。これは2つの異なる仕組みを混同した説明です。
Search・Training・Agentはそれぞれ何をするクローラーか
3分類は、取得したデータの使われ方で分かれています。
Searchは検索インデックスの取得です。取得結果は検索結果のリンクと短い抜粋になり、ユーザーはクリックしてサイトに来ます。
Trainingはモデルの学習データとしての取得です。その1回の取得が直接ユーザーの目に触れるわけではありません。
Agentは、ユーザーの質問に答えるためのその場の取得です。ユーザーが入力した瞬間に生成AIがWebページを取りに行き、その結果が回答文と出典リンクになります。
引用の生命線はAgent——ChatGPTもPerplexityも回答時に取りに来る
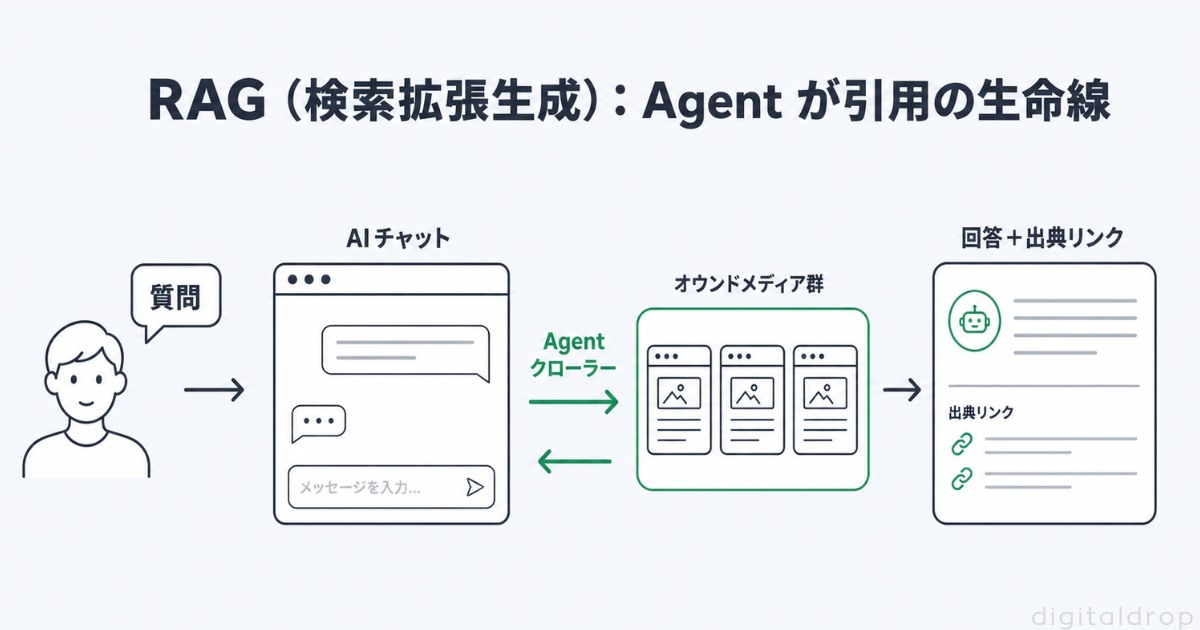
生成AIが回答に出典リンクを表示する仕組みは、検索拡張生成(RAG:Retrieval-Augmented Generation)と呼ばれます。回答を作る直前にWebから情報を取得し、その内容をもとに回答を組み立てる方式です。この取得を担うのがAgentクローラーです。したがって、次の関係が成り立ちます。
- Trainingをブロックしても、Agentが通れば生成AIの回答に引用される
- Trainingを許可していても、Agentを塞げば引用されなくなる
9月15日の既定変更は、TrainingとAgentの両方を広告掲載ページでブロックします。引用可視性への実害は、Agent側から生じます。
押さえておくべき整理 AI学習を拒否したいという判断と、AI検索での引用を確保したいという判断は、両立します。Trainingを閉じてAgentを開ける。この組み合わせが、多くの事業会社にとっての現実解です。既定値はこの組み合わせになっていません。
robots.txtのsearch・ai-input・ai-trainとの対応関係
Cloudflareは2025年9月24日に「Content Signals Policy」を公開しています。robots.txtに1行を足すことで、コンテンツの使われ方への意思を表明する仕組みです。
出典:Cloudflare公式ブログ「Giving users choice with Cloudflare’s new Content Signals Policy」(2025年9月24日)
定義されているシグナルは3つです。
| シグナル | 意味 | 対応するクローラー分類 |
| search | 検索インデックスへの利用。リンクと短い抜粋を含み、AI生成の要約は含まない | Search |
| ai-input | 生成AIの回答へのリアルタイム利用(RAG) | Agent |
| ai-train | AIモデルの学習・ファインチューニングへの利用 | Training |
記述形式はカンマ区切りの1行で、`Content-Signal: search=yes, ai-train=no` のように書きます。シグナルを省略した場合は「許可も拒否もしない」中立の扱いです。設定文はcontentsignals.orgで生成できます。
ただし注意点があります。Content Signalsはあくまで意思表示であり、技術的な遮断手段ではありません。実効性を持たせるには、Cloudflareの管理画面側の設定やWAFルールと組み合わせる必要があります。
オウンドメディアへの実害を数値で見積もる
「AI経由の流入はまだ小さいから、後回しでよい」という判断は、2026年時点では成立しにくくなっています。量ではなく質で見ると、評価が変わるためです。
AI経由流入は「量は少なく、質は高い」
Adobeは2026年4月16日に「2026 Q2 AI Traffic Report」を公開しました。米国小売サイトを対象とした分析で、次の結果が出ています。
- AI経由の流入は2026年第1四半期に前年比393%増加
- 2026年3月時点で、AI経由の訪問者は非AI経由より42%高いコンバージョン率
- 滞在時間は48%増、訪問あたり収益は37%増
1年前の2025年3月時点では、AI経由の訪問者のコンバージョン率は非AI経由を38%下回っていました。1年で逆転しています。
Similarwebの2026年6月時点の集計でも、生成AIプラットフォーム全体の月間訪問数は前年比70%増の95億に達し、米国でChatGPTの回答に出典が示される割合は2025年6月の1.6%から2026年5月の6.8%へ上昇しました。
ただしBtoBのマーケターが押さえるべき数字は別にあります。同じ集計で、プロフェッショナルサービス分野の引用率は4%未満。旅行・宿泊の約23%、自動車の約20%と比べて明確に低い水準です。
BtoBサービス領域では引用の総量がまだ小さい。だからこそ、確保できている引用経路を自分から塞ぐ判断のコストが相対的に大きくなります。
クロール対リファラル比率が示す、AI各社の非対称性
Cloudflareは、各社のクローラーが「何ページをクロールし、何件の参照トラフィックを返したか」の比率(crawl-to-refer ratio)をCloudflare Radarで公開しています。
2026年夏時点の公開データでは、学習中心の事業者ほどこの比率が極端に大きくなります。数百から数千ページのクロールに対して参照が1件という水準です。一方でGoogleやDuckDuckGoは、本来の機能がユーザーをサイトへ送ることであるため、数対1にとどまります。
さらにCloudflareが2026年6月時点で公開した内訳では、クローラーリクエストの52%が学習目的でした(2025年春は22%)。検索・エージェント・学習を兼ねる混在クローラーが36%超を占め、純粋な検索目的のクロールが占める割合は小さく、かつ減少しています。回答生成の多くは、ユーザーがチャット画面から出ないゼロクリックで完結します。
この非対称性が既定変更の背景にあります。ただし、その対処として自社の引用経路まで閉じるかは、パブリッシャーと事業会社で判断が分かれる論点です。
複合クローラー問題——Trainingを止めるとGooglebotも止まりうる
もっとも実害が出やすいのがこの論点です。
Googlebot、Applebot、Bingbotは、検索インデックスの構築とAI関連の用途を兼ねています。Cloudflareの説明によれば、複数の目的を持つクローラーは、該当するすべての挙動に制限が適用されます。
つまりTrainingをブロックする設定を選ぶと、Searchを許可していても、Search兼Trainingの複合クローラーがブロックされうるということです。検索流入そのものを失うリスクが発生します。
Cloudflareは、この挙動を望まない顧客に対して、9月15日より前にセキュリティ設定で意思表示するよう案内しています。
外資系日本支社にだけ起きる「気づけない」構造
ここまでは、すべてのサイト運営者に共通する話です。外資系企業の日本支社には、これに組織構造の問題が重なります。
Cloudflareアカウントは本社IT、コンテンツ責任は日本支社
多くの外資系企業では、CDNとセキュリティを本社のIT部門またはセキュリティ部門がグローバル一括で契約しています。日本支社のマーケティング担当者には、Cloudflare管理画面のアカウントすら発行されていないケースが珍しくありません。
一方で、日本語オウンドメディアのコンテンツ責任、KPI、そして流入減少の説明責任は日本支社にあります。権限と責任が分離している。これが外資系日本支社に固有の構造です。
当社がAI検索診断を行う際も、robots.txtやボット管理の設定確認は、コンテンツ品質より先に見る項目として扱っています。設定は1行で変わりますが、コンテンツの改善には数か月かかるためです。
日本支社が新規LPを立てた瞬間に、既定ブロックが適用される
前述のとおり、既定変更の対象には「既存アカウントに新しく追加されるサイト」が含まれます。
日本支社の実務でこれに該当するのは、次のようなケースです。
- 1. 日本市場向けキャンペーンの専用LPを新しいドメインで立ち上げる
- 2. 日本語オウンドメディアを本体サイトから分離して別ドメインで運用する
- 3. 展示会・ウェビナー用の期間限定サイトをサブドメインで追加する
- 4. 日本独自サービスの紹介サイトを新設する
いずれも、マーケティング部門が主導し、IT部門には「ドメインを追加してほしい」という依頼だけが飛ぶ作業です。追加されたサイトに新しい既定値が適用されても、依頼元には通知されません。
本社のグローバルAIポリシーが、日本のAI検索可視性を殺す
もう1段大きなリスクがあります。本社の法務部門やブランド部門が「自社コンテンツをAIの学習に使わせない」というグローバル方針を定め、IT部門が全ドメインに一律適用するケースです。
方針そのものは合理的です。問題は、実装時にTrainingとAgentが区別されないことです。「AI関連のクローラーをすべてブロック」という指示は、日本語オウンドメディアの引用可視性を同時に失わせます。
この構図は、個人情報保護法改正2026がマーケティングに与える影響で扱った、本社のグローバル規程と日本の実務要件が食い違う問題と同じ性質を持ちます。日本支社側から、技術的な粒度を伴った説明を上げる必要があります。
9月15日までに確認すべき7項目【チェックリスト】
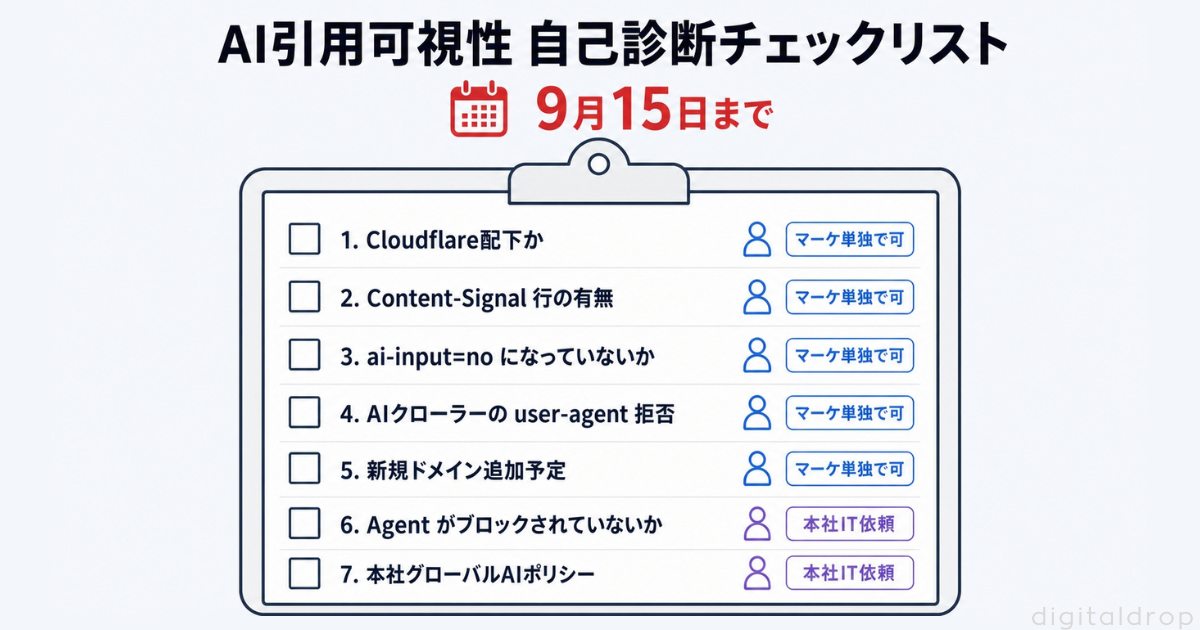
ここからは実行フェーズです。マーケティング担当者が自分で確認できる項目と、本社IT部門に依頼すべき項目を分けます。以下の表はそのまま稟議資料や本社報告に添付できる形にしています。
AI引用可視性 自己診断チェックリスト
| # | 確認項目 | 確認方法 | 担当 |
| 1 | 自社サイトがCloudflare配下か | 応答ヘッダーの `server: cloudflare` を確認 | マーケ単独で可 |
| 2 | robots.txtに `Content-Signal` 行があるか | `https://自社ドメイン/robots.txt` を開く | マーケ単独で可 |
| 3 | `ai-input` が `no` になっていないか | 同上。`ai-train=no` のみなら引用経路は維持 | マーケ単独で可 |
| 4 | AI関連クローラーがUser-agentで拒否されていないか | robots.txtの `GPTBot` `ChatGPT-User` `PerplexityBot` 記述を確認 | マーケ単独で可 |
| 5 | 9月15日以降に新規ドメインを追加する予定があるか | 自部門のサイト立ち上げ計画を棚卸し | マーケ単独で可 |
| 6 | ボット管理でAgentがブロックされていないか | Cloudflare管理画面の設定確認 | 本社IT依頼 |
| 7 | 本社にグローバルAIポリシーが存在するか | 法務・IT部門へ照会 | 本社IT依頼 |
項目1から5は、管理画面の権限がなくてもブラウザだけで確認できます。まずここまでを自分で終わらせてから、本社への照会に進むのが最短です。
Cloudflare管理画面での確認手順
項目6と7の確認を依頼する際は、操作場所を具体的に指定します。
- 1. Cloudflareダッシュボードにログインする
- 2. 対象ドメインを選択する
- 3. Security(セキュリティ)を開く
- 4. Settings(設定)内の「Configure AI bot policies」を開く
- 5. Search・Training・Agentそれぞれの設定値を確認する
- 6. Agentが「Allow(許可)」になっているかを確認する
各分類の選択肢は「全ページでブロック」「広告掲載ページでブロック」「許可」の3つです。確認してほしいのは、Agentが「許可」であるかどうかの1点に絞ります。
出典:Cloudflare AI Crawl Control 公式ドキュメント
本社IT部門への確認依頼テンプレート
本社へのエスカレーションは英語で、かつ「何を見て、何を答えてほしいか」を限定して送るほうが返信が早くなります。以下はそのまま使える文面です。
本社IT部門への依頼文(英日併記) Subject: Request to confirm AI bot policy settings before Sept 15 Cloudflare will change default AI crawler settings on September 15, 2026. On ad-serving pages, Training and Agent crawlers will be blocked by default for newly added domains and free-plan sites. Blocking the Agent category stops ChatGPT and Perplexity from retrieving our pages at answer time, which removes us from AI search citations. This is separate from AI training. Could you confirm the following for our Japan domains? 1. Current setting for the Agent category (Security > Settings > Configure AI bot policies) 2. Whether any global policy blocks AI-related crawlers across all domains 3. The default that will apply to domains we add after September 15 Our request: keep Agent set to Allow. We have no objection to restricting Training.
依頼のポイントは、Trainingへの制限に反対していないと明示することです。学習拒否というグローバル方針そのものを否定せず、Agentだけを切り分けて確保する。この進め方であれば、法務・ブランド部門の懸念と衝突しません。
ブロックすべきか、開けるべきか:ケース別の判断基準
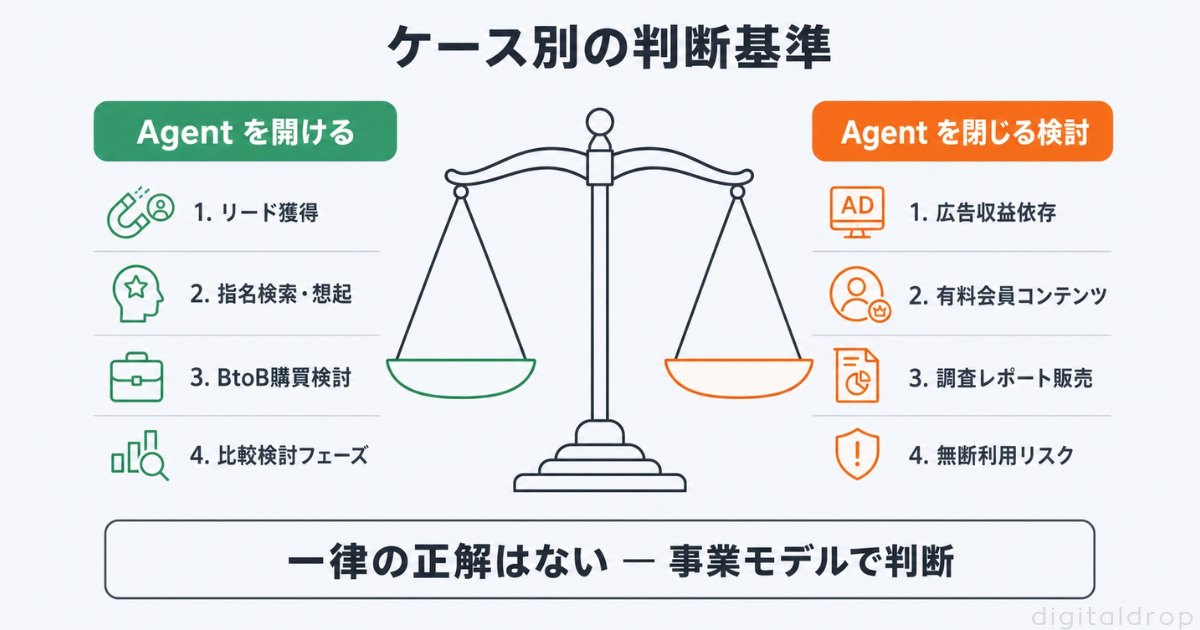
一律の正解はありません。事業モデルによって、失うものと守るものが変わります。
開けるべきケース/閉じるべきケース
Agentを開けるべきケース
- オウンドメディアからのリード獲得が主目的である
- 広告収益に依存していない事業会社である
- 指名検索・比較検討フェーズでの想起獲得を狙っている
- BtoBで、購買検討者が生成AIで情報収集している
Agentを閉じることを検討すべきケース
- 広告収益がサイトの主な収益源である
- 有料会員向けコンテンツを提供している
- コンテンツそのものが商品である(調査レポート、データベース等)
- コンテンツの無断利用が実損に直結する
注意点も書いておきます。Agentを開けても、生成AIの回答内で読者の疑問が解決すればクリックは発生しません。開けること自体が流入を保証するわけではなく、「回答の中で完結しないコンテンツ」を作る必要があります。
また前述のとおり、Content Signalsは意思表示であって強制力を持ちません。閉じる判断をした場合も、シグナルだけで守れると考えるのは危険です。
体制・予算別の現実解
| 体制 | 優先すべき対応 | 想定工数 |
| マーケ1人体制・外注中心 | チェックリスト項目1〜5を自分で確認し、問題があれば本社へ1通照会する | 2〜3時間 |
| 本社報告が必要な体制 | 上記に加え、AI経由流入の現状値を測定して報告資料に添付する | 1〜2日 |
| 複数ドメインを運用 | ドメイン一覧を作り、9月15日以降の追加予定と合わせて棚卸しする | 3〜5日 |
いずれの体制でも、2〜3時間で終わる項目1〜5を先に片付けてください。ここで問題が見つからなければ、優先度を下げて構いません。体制ごとの施策設計の考え方はカスタマーマーケティングの実務でも扱っています。
9月15日以降に効く、AIに引用されるコンテンツの作り方
設定を確保したうえで問われるのは、引用に値するコンテンツがあるかどうかです。
引用されやすいページ類型は「導入事例・比較・一次データ」
生成AIが回答の根拠として引きやすいのは、検証可能な固有情報を持つページです。一般論の解説記事は、モデルが学習済みの知識と重複するため、わざわざ出典として示される必要がありません。
BtoBで引用されやすい類型は、おおむね次の3つに絞られます。
- 1. 導入事例 — 企業名、業種、規模、導入前の課題、定量成果という固有の組み合わせを持つ
- 2. 比較・選定基準 — 条件別の推奨という、生成AIの回答構造そのものと形式が一致する
- 3. 一次データ — 自社調査、価格実績、ベンチマークなど、他に出典が存在しない数値
このうち、導入事例は、外資系日本支社にとって供給が難しい領域です。本社には英語事例があるが、日本の事例がない、あるいは顧客名を出せないという制約が重なります。
当社が事例制作で最初に確認するのも、この供給制約の中身です。実名が出せない場合でも、業種・規模・導入前の課題・定量成果の粒度を上げれば検証可能性は維持できます。詳細は導入事例の作り方で整理しています。
本社の英語事例を日本語で使える形にする作業も同じ文脈です。翻訳だけでは日本の検討者が求める粒度に届かず、追加取材と再構成が必要になります。
AI経由流入をどう測るか
LLMO・GEOと呼ばれる生成AI向け最適化の効果測定でつまずくのが、この計測部分です。AI経由の流入はGA4の標準レポートでは独立したチャネルとして分離されず、参照元ドメインで判別する必要があります。
主な参照元は次のとおりです。
- chatgpt.com / chat.openai.com
- perplexity.ai
- gemini.google.com
- claude.ai
- copilot.microsoft.com
これらをGA4の探索レポートでセグメント化し、月次で推移を見ます。ただし、AI Overviewsのように参照元が通常の検索と区別されないケースもあるため、この数値は下限値として扱ってください。
Cloudflareを利用しているなら、AI Crawl Controlの管理画面でクローラー別のアクセス状況も確認できます。Agent系クローラーが実際に来ているかは、こちらのほうが確実です。
AI検索での可視性確保はデジタルドロップにお任せください
デジタルドロップは、AI検索での引用可視性の診断から、引用されるコンテンツの制作までを一社で担当します。技術設定の確認とコンテンツ改修が分断されない点が、外資系日本支社のご担当者にとっての実務上の利点です。
AI検索診断では、robots.txtとボット管理の設定確認を含め、技術基盤・コンテンツ品質・第三者言及の3領域を評価します。本社IT部門への照会が必要な項目は、英語の依頼文面まで含めてお渡しします。
導入事例制作では、顔出しや実名の制約がある案件でも、検証可能性を維持した事例を制作します。本社の英語事例を日本市場向けに再構成する作業にも対応します。
初めてAI検索対応を外部に相談される場合の、最初の一社としてご検討ください。
よくある質問
Q1. 既存の本番ドメインも、9月15日に自動で設定が変わりますか。
いいえ。2026年9月15日の既定変更が適用されるのは、新しくCloudflareへ接続するドメイン、既存アカウントに新しく追加されるサイト、および無料プランのサイトです。すでに有料プランで運用中の本番ドメインは、自動では切り替わりません。ただし9月15日以降に新しいドメインやサブドメインを追加する場合は、そのサイトに新しい既定値が適用されます。
Q2. AI学習をブロックすると、検索順位に影響しますか。
影響する可能性があります。Googlebot、Applebot、Bingbotは検索インデックスの構築とAI関連の用途を兼ねており、複数目的のクローラーには該当するすべての制限が適用されます。Trainingをブロックすると、Searchを許可していても複合クローラーが遮断されうるとCloudflareは説明しています。9月15日より前であれば、セキュリティ設定でこの挙動を望まない旨を表明できます。
Q3. 広告を掲載していないコーポレートサイトでも、対応は必要ですか。
既定変更は広告掲載ページが対象のため、直接の影響は限定的です。ただし確認は必要です。本社のグローバル方針としてAI関連クローラーが全ドメインで一律ブロックされている場合、広告の有無に関係なく引用経路が閉じるためです。チェックリスト項目1〜5は広告の有無を問わず実施してください。
Q4. robots.txtのContent Signalsと、Cloudflareの管理画面設定はどちらが優先されますか。
性質が異なります。Content Signalsは「意思表示」であり、技術的な遮断手段ではありません。クローラー側が無視することもあります。一方でCloudflareの管理画面設定やWAFルールは、実際にリクエストを遮断します。実効性を持たせたい場合は管理画面側の設定が必要で、Content Signalsはその意図を明文化する補完手段と位置づけてください。
Q5. AI検索での可視性を診断・改善する費用は、どれくらいかかりますか。
費用は診断範囲と改修規模で決まります。費用を左右する主な変数は、対象ページ数、多言語対応の有無、既存コンテンツの改修か新規制作か、そして本社への報告資料まで含めるかの4点です。技術設定の確認だけであればスポットで完結しますが、引用されるコンテンツの制作まで含める場合は継続的な運用が前提になります。具体的な条件をお伺いしたうえでお見積りいたしますので、お問い合わせください。
Q6. 本社が設定変更に応じてくれない場合、日本支社にできることはありますか。
あります。まずTrainingとAgentを分けて説明し直してください。「AI学習は拒否したままでよい。回答時の取得だけ許可してほしい」という限定的な依頼であれば、法務・ブランド部門の懸念と衝突しません。それでも動かない場合は、日本市場向けの新規ドメインで個別設定を確保する交渉に切り替えるほうが現実的です。AI経由流入の現状値を測り、失うものを数値で示すと通りやすくなります。
AIクローラーブロック影響まとめ
- 2026年9月15日のCloudflare既定変更は、新規ドメイン・新規追加サイト・無料プランが対象であり、既存の本番ドメインが自動で切り替わるわけではない
- AIクローラーのブロックが引用に与える影響は、TrainingではなくAgentから生じる。学習拒否と引用確保は両立可能であり、既定値はその組み合わせになっていない
- 外資系企業の日本支社は、権限が本社IT部門にあり責任が日本支社にあるという構造上、変更に気づけない。まずブラウザだけで確認できる5項目を自分で終わらせ、そのうえでAgentの設定1点に絞って本社へ照会するのが最短である
あわせて読みたい関連記事
 SEO対策
AI記事の量産が逆効果な理由と質を担保する5つの仕組み徹底解説
AI記事の量産はなぜ逆効果なのか。質を捨てた量産が読者・Google・生成AIに見抜かれ、ブランドと検索・AI評価を二重に毀損する仕組みを解説。翻訳・DTPまで含めた量産の落とし穴と、質を担保する5つの仕組みを実例で紹介します。
 SEO対策
多言語SEOで失敗しない|URL構造・hreflang・現地化の実践手法
「多言語SEO」と検索してこの記事にたどり着いたあなたは、本社サイトを日本語化したのに流入が伸びない、あるいは海外展開の第一歩で迷っているのではないでしょうか。実は、多言語SEOを「翻訳プロジェクト」として進めた瞬間に、 […]